把一个大模型接进机器人并不难。难的是接进去之后,机器要面对的不再是语言世界的考卷——判断一旦出错,杯子已经碎了,零件已经坏了,人也已经站在旁边。
WRC观察
过去已经有机器人。它们可以焊接汽车,可以在仓库里搬货,也可以在手术中辅助医生完成极其精细的操作。在结构化、重复性的任务中,一些机器人已经能够实现人很难长期保持的精度、速度和稳定性。
那么,为什么今天又多出了一个词:具身 AI?
最简单的解释是:具身 AI 是「拥有身体的人工智能」。但这句话几乎没有解释任何东西。工业机器人本来就有机械臂,移动机器人本来就有轮子,机器也早就通过传感器感知环境。仅仅拥有一个物理身体,并不足以说明这一轮变化到底发生在哪里。
更准确的理解是:具身 AI 要解决的,是让机器在环境没有被完全整理好、任务没有被逐步写死的情况下,仍然能够理解目标、选择行动,并根据结果继续调整。
有身体,不等于有理解
真正的区别,可以从一个很普通的任务开始。假设你对一台机器人说:把桌上那个快要掉下去的袋子拿回来。
这句话对人很简单。但对于机器,它至少包含一整条能力链:它要先看见桌面上有哪些东西;理解「那个袋子」指的是哪一个;判断什么叫「快要掉下去」;规划手臂从哪里接近才不会碰倒旁边的杯子;控制手指用合适的力量抓住柔软包装;拿起以后还要确认袋子没有滑落,最后再把它放到安全位置。如果中途有人移动了杯子,它还要重新判断。
看见 → 理解 → 规划 → 行动 → 验证结果 → 纠正或求助 → 记录反馈。
需要说明的是,这条链是我们用来解释具身 AI 的框架,不是行业标准。而且记录反馈并不等于机器人会在运行中自动学习——反馈能否进入下一轮训练、审核和版本更新,还取决于另一套数据与工程机制。
过去的很多机器人,并不是完全没有这些能力。差别在于,大量传统自动化把其中很大一部分提前交给了工程师:预先确定物体位置,设计夹具,标定轨迹,把动作写进程序,再用围栏和标准化流程尽可能保持环境不变。
这是一条非常成熟、可靠而且仍然重要的路线。具身 AI 想要向前推进的,是让机器人在环境并不完全确定、任务没有被逐步写死的情况下,仍然能够理解目标、选择行动,并根据结果继续调整。
从「看懂」到「会做」,中间隔着动作
要做到这一点,机器人先得知道眼前有什么、东西在哪里,以及自己的手是否已经接触目标。
视觉语言模型,也就是 VLM,负责把「看见的东西」和「听懂的任务」联系起来,让机器理解「红色杯子」「桌边的袋子」分别指向什么。
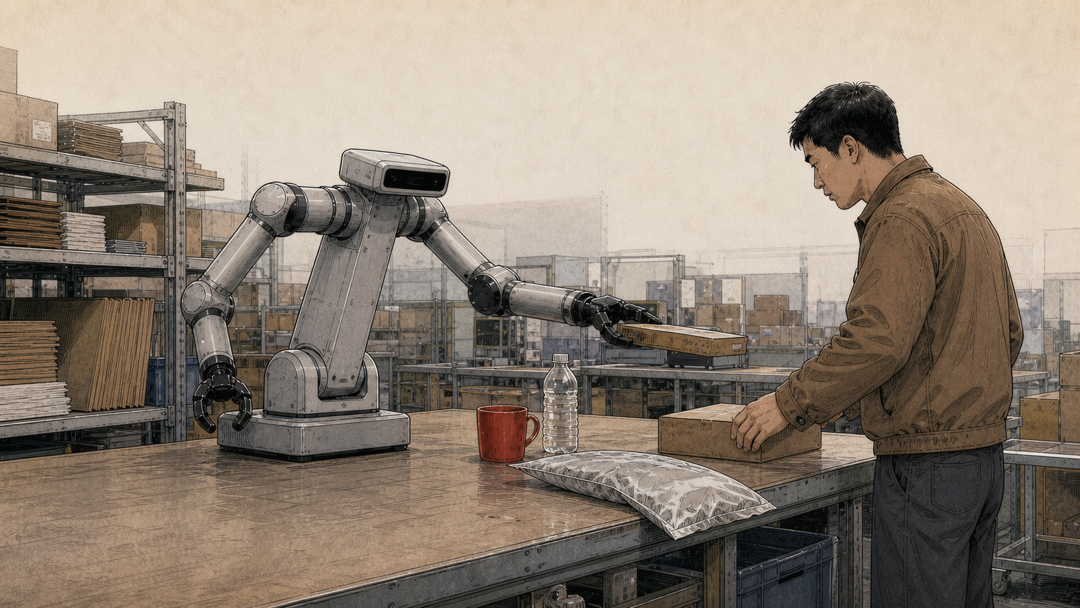
但看懂还不等于会做。于是又出现了 VLA——视觉、语言、动作模型。它继续追问:看懂以后,机器下一步究竟该怎么动?模型的输出不再只是一句话,还可能是移动、旋转、抓取或者停止。
我们理解数字 AI 时,已经逐渐学会把不同能力放回自己的位置:向量和 RAG 解决知识检索,MCP 负责连接外部系统,Skill 封装可复用能力,Agent 承担任务并调用工具。具身 AI 也是一样,不能只看一个大模型,更不能只看机器人本体。
它还要把「理解」跨过一道更难的门槛——变成真实世界里的动作。
纯文本回答出错,往往还有重新生成和人工核验的机会;但数字 AI 一旦调用报价、付款、客户系统或外部工具,同样可能产生真实后果。具身 AI 更直接的风险在于,它的输出会立即变成物理世界中的力量、速度和位移。判断一旦错误,杯子可能已经碎了,零件可能已经损坏,设备或人员也可能受到影响。
行动之前要预判,行动之后要确认
这也是为什么机器人「知道应该怎么做」,仍然可能做不好。模型也许正确识别了插头和接口,却会因为几毫米偏差插不进去;它也许理解了「拿起纸杯」,却会因为力量过大把杯子捏变形;它也许规划了正确路线,却会因为地面摩擦、光线变化或者临时出现的障碍而失败。
只知道当前看见什么还不够,机器人还要估计行动可能带来的后果。这也是世界模型受到重视的原因,它试图回答:如果我这样做,接下来世界可能变成什么样?如果推动箱子,会不会碰倒后面的瓶子?如果这一步失败,应该继续、重试,还是停下来交给人?
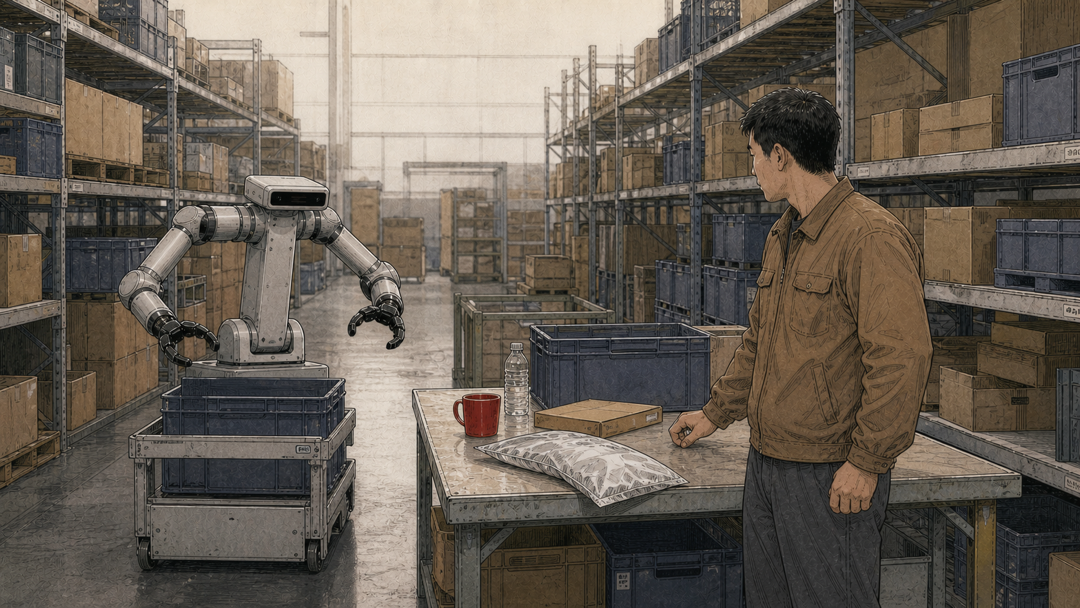
这些技术词背后其实是同一个问题:机器人能不能在行动之前预判,在行动之后确认,在失败时恢复。但不同路线仍在快速发展,今天没有一种架构已经被证明能适用于所有机器人、所有任务和所有经营现场。
物理世界的考卷,比语言世界严格
另一个困难是数据。互联网有海量文本、图片和视频,但机器人需要的数据必须带着动作及其后果:手用了多大力量,物体有没有滑落,失败以后怎样调整。
这些数据常常要靠机器人反复尝试,或者由人通过遥操作和示范来采集。仿真和合成数据可以扩大规模,却很难完整复制现实中的摩擦、材质、光照和偶发变化。行业把这道落差称为 Sim2Real:在仿真里会做,不代表到了真实现场仍然会做。
而真正进入工作以后,现场又会产生新的数据。哪些包装最容易滑落,哪些光线会造成误判,什么异常最常需要人工接管——这些不再只是研发数据,也可能逐渐变成企业的运行经验。
因此,具身 AI 并不是「给机器人装上一个大模型」。它更像一条跨越数字世界和物理世界的技术能力链:需要看见和理解,需要规划和控制,需要身体真正完成动作,也需要验证结果;失败以后,它还要安全停止、接受人工接管并记录反馈。反馈能否成为下一轮改进,则要经过数据治理、人工审核、训练和版本更新。
这也解释了为什么今天的机器人常常呈现出一种看似矛盾的状态:它们可以完成过去很难想象的任务,也会在一个人类几乎不用思考的动作上反复失败。这不是因为前面的进步都是假的,而是因为物理世界的考卷,远比语言世界严格。
会行动,还不等于能上岗
理解一句指令只是开始。真正的具身能力,要在行动中被证明。
但具备这些技术能力,并不自动意味着机器人已经成为「AI 员工」。具身 AI 回答的是机器怎样在物理世界中理解和行动;AI 员工化还要求它被赋予相对稳定的组织角色,并被纳入任务、知识、权限、协作、监督、评价和人工接管机制。
会行动,是进入经营现场的能力条件;能被组织和管理,才是进入企业运行体系的开始。
对县域工厂、仓库、门店和服务企业来说,这句话可以直接换成一句更实用的问法:这个任务的环境是不是确定的?步骤能不能被写死?如果写不死,机器出错的时候,谁来停、谁来接、谁负责?
甲叔判断
别被「有身体的人工智能」这句话糊弄过去。机器人早就有身体了,这一轮真正贵的地方,是让它在环境没被整理好的时候还能自己判断、自己调整、出错能停。所以对经营者来说,判断标准要换成三句话:这个任务的环境能不能被固定?步骤能不能写死?写不死的时候,机器出错谁接?三句都答得上来,再谈采购。
OPCBoss 方法
看具身 AI,不要只看模型参数和本体形态,要看一条链是否完整:能不能看见和理解任务,能不能把理解变成动作,能不能验证结果,失败时能不能安全停止并交给人,反馈能不能进入下一轮改进。这五段缺任何一段,机器人都只是一台更聪明的设备,还不是企业可以持续调用的能力。这也是 OPC化在物理行动层面的判断起点——更小的经营单元,能否获得过去依赖大型组织才拥有的行动能力。
经营现场怎么做
- 先盘任务的确定性。列出候选任务,标注环境是否固定、对象是否统一、步骤能否写死。环境越不确定,越需要具身 AI,也越需要更长的验证周期。
- 再测失败怎么收场。做小规模验证时,重点不是成功一次,而是看它出错时能不能安全停下、能不能被人工接回、异常有没有被系统记录下来。
- 最后问数据归谁。运行产生的失败样本、接管记录和工艺参数,是继续改进的唯一燃料。合同里要写清归属、导出方式和退出时的迁移成本。